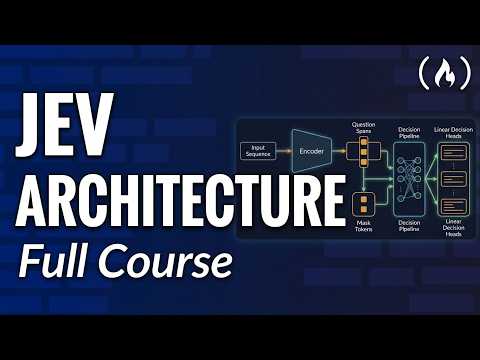
Современные языковые модели традиционно решают задачи классификации и принятия решений через авторегрессионную генерацию структурированного текста (например, JSON), что создает значительные накладные расходы по задержке и вычислительным ресурсам. Инженер и автор обучающих курсов Вивек Кальянаранган в материале для платформы freeCodeCamp детально разбирает концепцию Jev — архитектурного подхода, заменяющего многоэтапный декодинг одиночным прямым проходом (prefill-only) с фиксацией детерминированных вероятностей. В рамках курса рассматриваются реализации на базе как энкодеров, так и декодеров, тонкости построения кастомных масок внимания для параллельной обработки вопросов, а также алгоритмы обучения с подкреплением RLCD и GRPO.
⚡ Что такое Jev: отказ от авторегрессии в пользу Prefill-Only 1:12
Классический цикл инференса большой языковой модели состоит из двух фундаментально разных фаз: префилла (prefill) и декодинга (decode) . В фазе префилла модель параллельно обрабатывает весь входящий промпт; данная операция ограничена преимущественно вычислительной мощностью процессора или видеокарты (compute-bound) . В фазе декодинга модель генерирует ответ авторегрессионно — строго по одному токену за шаг, возвращая сгенерированный токен обратно на вход сети .
По словам Вивека Кальянарангана, если контекст задачи составляет 500 токенов, для получения ответа модель сначала прогоняет 500 токенов, затем 501, 502 и так далее, пока не упрется в стоп-токен . При решении прикладных инженерных задач — маршрутизации тикетов, классификации транзакций или скоринге рисков — такой подход приводит к двум фундаментальным проблемам:
- Неконтролируемая и высокая задержка (latency), растущая линейно с каждым сгенерированным токеном .
- Необходимость парсинга свободного текста или структуры JSON, что требует валидации схемы и порождает риск синтаксических сбоев .
Идея системы Jev заключается в полном исключении фазы декодинга . Вся задача формулируется таким образом, чтобы модель выдавала готовое решение за один прямой проход (single forward pass) в рамках фазы префилла . Это гарантирует строго ограниченную задержку и математически предсказуемый вывод в виде вероятностного распределения по заранее определенным категориям .
🛠️ Интерфейсы решений и требования к стеку 3:26
Архитектура Jev предоставляет разработчику унифицированный API для трех ключевых типов логических запросов :
- Choice (Выбор): номинальная классификация среди взаимоисключающих ортогональных категорий без естественного порядка (например: направления «север», «юг», «запад», «восток» или варианты действий) .
- Score (Оценка): порядковая (ординальная) классификация, где между классами существует градация (например: эмоциональный тон клиента — «спокойный», «раздраженный», «в ярости») .
- Boolean / Null (Логический тип): бинарные вопросы формата «да/нет», возвращающие вероятность истинности утверждения .
Кальянаранган подчеркивает, что все три интерфейса на уровне базовой реализации могут опираться на единый расчет функции Softmax для распределения логитов, однако их калибровка и математическая оценка при обучении существенно различаются .
Для воспроизведения рассматриваемых пайплайнов не требуется кластер GPU — весь инференс можно выполнять на CPU . Ключевыми требованиями являются уверенное владение PyTorch, понимание механизма внимания (Self-Attention), структуры KV-кэша, а также концепций логитов и Softmax . В качестве основы для разбора используются открытые предобученные модели из экосистемы Hugging Face .
🐢 Базовый уровень: почему посимвольный авторегрессионный декодинг неэффективен 8:00
Для демонстрации недостатков стандартного подхода автор разбирает сценарий антифрод-мониторинга . Модели передается контекст: с банковской карты, оканчивающейся на 4412, совершено 9 транзакций за 3 минуты в четырех странах, при этом владелец заявляет, что физическая карта находится у него в кармане .
В стандартной парадигме разработчик отправляет промпт через интерфейс, аналогичный OpenAI API или библиотеке Pydantic, ожидая JSON следующего формата :
{
  "priority": "high",
  "decision": "fraud",
  "escalate": true
}
В демонстрационном коде используется квантованная модель Qwen с 3,6 млрд параметров . Вектор входных идентификаторов промпта (включая системные инструкции и открывающую фигурную скобку {) составляет порядка 130 токенов , .
На каждом шаге авторегрессионного цикла модель вычисляет тензор логитов размерностью [1, 130, 152000], где 152 000 — объем словаря (vocabulary size) . Чтобы получить один токен, скрипт:
- Берет срез последнего токена
[-1, :]. - Применяет к вектору логитов функцию Softmax .
- Находит индекс с максимальной вероятностью через операцию
argmax. - Добавляет новый токен в конец последовательности, обновляет KV-кэш и повторяет прямой проход для вычисления следующего токена , .
Модели требуются десятки итераций только для генерации служебных символов: кавычек, двоеточий, переносов строк и названий ключей ("priority", "decision") , . На накладные расходы форматирования тратится львиная доля времени, хотя прикладной системе требовались лишь три конкретных значения .
🧩 Архитектура на базе Encoder-Only: маскирование и эмбеддинги запросов 21:24
Первая альтернатива авторегрессии — использование энкодерных моделей (семейства BERT или аналогичных маскированных языковых моделей, MLM) . Поскольку энкодер обладает двунаправленным вниманием (bidirectional attention), каждый токен видит контекст как слева, так и справа от себя .
Вивек Кальянаранган предлагает нестандартную структуру компоновки входной последовательности: вопрос ставится в самое начало, а исходный контекст (state) помещается в конец :
[CLS] Вопрос [SEP] [MASK] Вариант_A [MASK] Вариант_B [SEP] Контекст [SEP]
Причина такого порядка заключается в архитектурной особенности механизмов внимания, которые исторически присваивают больший вес начальным позициям последовательности . Перед каждым возможным вариантом ответа внедряется служебный токен маски [MASK] .
Главное ограничение энкодерного подхода связано с его двунаправленной природой . В энкодере невозможно переиспользовать кэш ключей и значений (KV-cache) для неизменного контекста: любое изменение вопроса или вариантов ответов в начале последовательности полностью пересчитывает веса внимания для каждого последующего токена . Поэтому при наличии 50 разных вопросов к одному документу энкодер вынужден заново прогонять весь контекст 50 раз .
💻 Реализация Encoder-подхода в PyTorch: от пулинга до линейных голов 25:26
В практическом разборе скрипта encoding.py демонстрируется обработка тикета службы поддержки: клиент жалуется на двойное списание за один заказ и угрожает чарджбэком через банк . Проверяется гипотеза: требует ли клиент возврат средств ("no", "yes") .
Векторизованная последовательность содержит 54 токена, а скрытое состояние (hidden state) последнего слоя имеет размерность [54, 768] . Для извлечения решения выполняются следующие математические преобразования:
- Пулинг запроса (Query Mean Pooling): определяются границы токенов самого вопроса (с 1 по 9 позицию, исключая токен
[CLS]) . Для этих 8 токенов вычисляется среднее арифметическое их скрытых состояний (mean pooling), что формирует итоговый вектор запроса размерностью[768]. - Извлечение векторов опций: фиксируются скрытые состояния на позициях токенов
[MASK], расположенных непосредственно перед вариантами ответов (например, позиции 10 и 12) , . В результате формируется матрица опций размерностью[2, 768]. - Скалярное произведение (Dot Product): вычисляется проекция вектора запроса на векторы опций . Полученные скаляры нормализуются с помощью Softmax, превращаясь в вероятности классов , .
Кальянаранган отмечает, что «сырая» предобученная модель BERT без дообучения выдает смещенные вероятности (например, 30% на «yes» вместо уверенного срабатывания), так как внутренние эмбеддинги не калиброваны под вероятностный вывод . Для адаптации энкодера в продакшене автор выделяет три пути :
- Линейная голова (Linear Head): добавление слоя
Linear(768, 1)поверх скрытого состояния маски для прямого предсказания скалярного логита . - Частичный Fine-Tuning: заморозка основы и обучение только классификатора .
- Полное дообучение (Full Backbone Fine-Tuning): сквозная оптимизация всех слоев трансформера .
🔄 Архитектура Decoder-Only: кэширование контекста и упаковка вопросов 40:42
Большинство современных LLM относятся к типу Decoder-Only (семейства Qwen, Llama, Gemma). В отличие от энкодера, каузальное (причинно-следственное) внимание позволяет зафиксировать контекст задачи в самом начале последовательности и закэшировать его в KV-кэш один раз .
Паттерн работы с декодером строится по принципу автодополнения (auto-complete) :
[Контекст документа] Вопрос: <текст вопроса>? Ответ:
После двоеточия модель должна сгенерировать ровно один токен . При расчете распределения первого токена отсекаются все 152 000 логитов словаря, кроме тех индексов, которые соответствуют целевым вариантам (например, идентификаторы слов "yes" и "no") . К оставшимся логитам применяется Softmax .
Модели декодеров способны поддерживать обработку сотен и тысяч вопросов к одному документу без повторного вычисления базового контекста . Если длина контекста модели составляет 32 000 токенов, а сам документ занимает 1 000 токенов, оставшиеся 31 000 позиций можно утилизировать под параллельные цепочки вопросов .
🎛️ Пользовательская причинная маска внимания и переиспользование KV-кэша 46:22
При попытке упаковать несколько вопросов в один контекст возникает фундаментальная проблема утечки внимания (context pollution) . Если вопрос №2 видит токены вопроса №1, итоговое решение модели начинает зависеть от порядка следования вопросов .
Кальянаранган обращает внимание на архитектурный изъян некоторых альтернативных решений (например, открытой реализации Clef от Cloudflare), где вопросы видят друг друга . В Jev применяется строгая изоляция с помощью кастомной 2D-маски видимости :
- Контекст видит только самого себя по стандартной каузальной маске (токены 0–37) .
- Вопрос №1 видит весь базовый контекст и свои собственные токены, но не видит последующие вопросы .
- Вопрос №2 видит базовый контекст и свои собственные токены, но его видимость токенов вопроса №1 принудительно зануляется (
False) , .
В коде decoder.py для 38 токенов контекста формируется KV-кэш: 28 слоев, 8 голо Compartment (KV-heads), скрытая размерность 128 , . Далее формируются тензоры сегментов (segments), разделяющие границы вопросов, и через операцию внешнего сравнения seg == seg.T создается маска принадлежности к одному вопросу . Объединение логического И между базовой каузальной маской (arange >= arange.T) и маской сегментов, дополненное полным доступом к токенам контекста, дает результирующую матрицу видимости размером [35, 73] для 35 токенов, формирующих вопросы , .
При вызове прямого прохода модели в PyTorch явно передаются предрассчитанный KV-кэш, позиционные индексы токенов (от 38 до 73 для корректной работы RoPE) и сгенерированная кастомная маска внимания , .
🎯 Извлечение логитов, коллизии токенов и калибровка решений 1:03:52
После выполнения прямого прохода извлекаются логиты точек принятия решений (decision points) — позиций, соответствующих последнему токену перед предполагаемым ответом , :
- Для первого вопроса точка принятия решения находилась на 18-м относительном токене; из словаря были выбраны токены с ID
902(«no») и9834(«yes») , . Вероятность того, что клиент просит возврат, составила 95% . - Для второго вопроса (определение ответственного отдела: «billing» против «technical») точка решения находилась на 34-м токене . Модель выдала ID
30531(«billing») с уверенностью 97% и ID10916(«technical») с вероятностью 2,5% , .
Проблема коллизии мультитокенов (Multi-Token Collision) 1:09:12
Если варианты ответов начинаются с одного и того же токена, наивный выбор вероятности по первому токену дает сбой . Например, в паре вариантов "fraud" и "fraud review" первый токен идентичен, и декодер не сможет разделить их вероятности за один шаг, выдав распределение 50/50 , .
Кальянаранган предлагает три способа решения коллизий , :
- Перефразирование: замена пересекающихся терминов на уникальные синонимы (например,
"fraud"и"review") . - Индексация через алиасы: формулирование задачи как Multiple Choice с выбором букв
A,B,C,D, . - Span Pooling: агрегация скрытых состояний по всей длине фразы варианта ответа с последующей классификацией через линейный слой , .
В энкодерах данная проблема отсутствует в принципе, поскольку токен маски привязан к конкретной позиции в предложении .
🎓 Обучение моделей: дистилляция «учитель — ученик» и GRPO 1:11:15
Хотя предобученный декодер способен решать задачи zero-shot, для достижения высокой калибровки вероятностей требуется специальный пайплайн обучения. В основе лежит схема дистилляции знаний «учитель — ученик» (Teacher-Student Distillation) .
В роли учителя выступает более мощная закрытая модель или размеченный датасет, формирующий целевое распределение вероятностей (например: 0.7 для «billing», 0.2 для «technical», 0.1 для «account») . Обучаемая компактная модель (студент) генерирует логиты (например: +1.0, +0.8, +0.2), которые после Softmax дают распределение [0.44, 0.36, 0.19] . Несмотря на сохранение рангового порядка, распределение студента нуждается в подтягивании к учителю .
Для оптимизации используется адаптация алгоритма GRPO (Group Relative Policy Optimization) из области обучения с подкреплением . Поскольку в парадигме prefill-only нет генерации длинных текстовых цепочек (траекторий), альтернативные траектории синтезируются искусственно :
- К базовым логитам студента добавляются различные случайные шумы (пертурбации) .
- Для каждого возмущенного вектора рассчитывается вознаграждение (reward) на основе близости к распределению учителя .
- Вычисляется среднее вознаграждение группы $\mu$ и стандартное отклонение $\sigma$ .
-
Для каждой траектории вычисляется преимущество (Advantage) по формуле : $$A_i = \frac{R_i - \mu}{\sigma}$$
-
Траектории с положительным преимуществом ($A_i > 0$) поощряются градиентным спуском, смещая веса студента в сторону учителя , .
📐 Функция потерь RLCD: комбинация Log Loss, Spherical Score и RPS 1:16:54
Фреймворк RLCD (Reinforcement Learning for Calibrated Decisions) опирается на комплексную функцию награды, оценивающую не просто точность совпадения меток, а математическую честность вероятностного распределения .
Награда $R$ складывается из трех ключевых метрик , :
-
Log Score (Логарифмический скор): логарифм вероятностей студента, взвешенный по вероятностям учителя : $$\text{LogScore} = \sum p_{\text{teacher}} \cdot \log(p_{\text{student}})$$ Метрика отвечает на вопрос: выделил ли студент высокую вероятность там же, где ее выделил учитель .
-
Spherical Score (Сферический скор): косинусоподобная метрика совпадения векторов вероятностей, нормализующая коллинеарность направлений предсказаний учителя и студента , .
- Ranked Probability Score (RPS): специализированная метрика для ординальных шкал (интерфейс Score) .
Вивек поясняет необходимость RPS наглядным примером: клиент находится в состоянии «в ярости» . Если модель выбирает между предсказаниями «раздражен» и «спокойный», стандартный Log Loss накажет обе ошибки одинаково . Однако с точки зрения калибровки ответ «раздражен» находится ближе к истине, чем «спокойный» . Метрика RPS вычисляет среднеквадратичную разность между кумулятивными суммами распределений (CDF) студента и учителя, штрафуя далекие промахи сильнее близких :
$$\text{RPS} = \frac{1}{K-1} \sum_{k=1}^{K-1} \left( \sum_{j=1}^k p_{\text{student}, j} - \sum_{j=1}^k p_{\text{teacher}, j} \right)^2$$
Итоговая функция потерь объединяет классическую кросс-энтропию и RL-компонент : $$\mathcal{L} = \mathcal{L}_{\text{CE}} - \left( \text{LogScore} + 0.75 \cdot \text{SphericalScore} - \text{RPS} \right)$$
Оптимизацию можно проводить как на уровне легковесных адаптеров LoRA или единичных классификационных голов, так и через Full Fine-Tuning базовой сети .
⚖️ Encoder против Decoder: инженерные компромиссы и выбор архитектуры 1:23:17
В финальной части курса Вивек Кальянаранган сопоставляет сильные и слабые стороны рассмотренных подходов, формируя матрицу архитектурных компромиссов для инженера :
- Кэширование контекста: абсолютное преимущество у Decoder-Only . Контекст читается один раз и оседает в памяти KV-кэша, после чего к нему можно адресовать неограниченное число дополнительных вопросов без нарастания вычислительной сложности . Энкодер вынужден заново пересчитывать всю матрицу внимания на каждый запрос .
- Длина контекста: декодеры масштабируются значительно лучше при работе с большими документами (10K+ токенов) .
- Плотность параметров и качество представлений: энкодеры выигрывают за счет двунаправленного внимания . Модель BERT на 400 млн параметров способна демонстрировать уровень качества извлечения признаков, сопоставимый с декодером на 2–3 млрд параметров .
- Мультитокенные опции: внедрение токенов маски
[MASK]в энкодере полностью исключает коллизии префиксов, тогда как в декодере разработчику приходится контролировать однотокенность ответов или применять алиасы , . - Сложность пайплайна: энкодер требует обучения проекционных линейных слоев практически с нуля, в то время как декодер обеспечивает приемлемое качество классификации прямо «из коробки» в режиме zero-shot , .
Выбор между энкодером и декодером сводится к балансу между доступной видеопамятью, требованиями к задержке и количеством вопросов, приходящихся на один неизменный фрагмент входных данных .